Les plateformes de test IA promettent d’écrire, d’exécuter et de réparer des tests de bout en bout, mais le bon choix dépend de qui maintiendra ces tests après le lancement. Ce guide compare quatre options pour les équipes SaaS et produit, à partir des pages éditeurs vérifiées le 19 octobre 2026, puis propose un budget et un pilote.
L’essentiel
Quatre plateformes de test IA comparées
 QA Wolf
- Idéal pour
- Développeurs voulant des tests portables, avec aide humaine en option
- Tarifs publiés
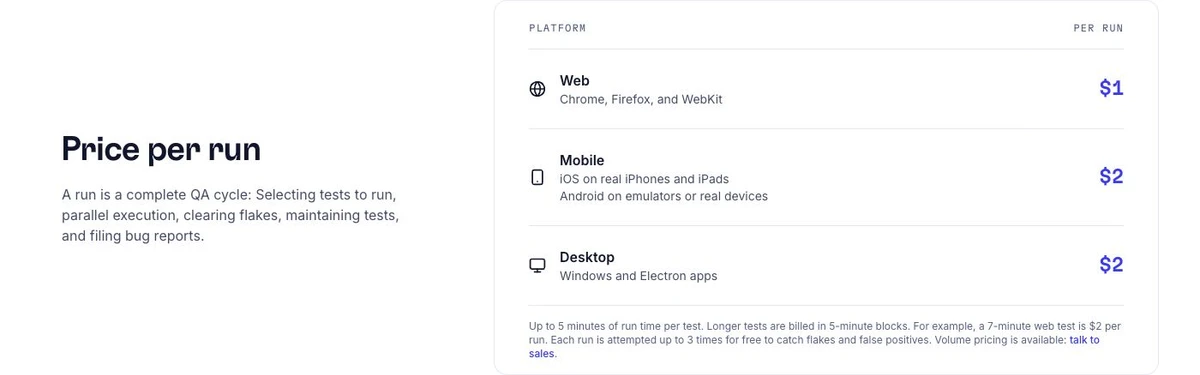
- 1 USD par exécution de test web ; 2 USD en mobile ou desktop
- Périmètre
- Web sur Chrome, Firefox et WebKit, plus mobile et desktop
- À vérifier avant d’acheter
- Le coût suit les exécutions, la durée et les plateformes ; fixez un plafond
 mabl
- Idéal pour
- Équipes QA voulant web, API et contrôles qualité au même endroit
- Tarifs publiés
- Sur devis ; essai de 14 jours
- Périmètre
- Web, API, accessibilité et performance ; mobile natif listé en option
- À vérifier avant d’acheter
- Le coût des crédits et les options mobiles exigent un devis écrit
 testRigor
- Idéal pour
- Équipes QA manuelles qui rédigent des étapes lisibles
- Tarifs publiés
- Offre gratuite publique ; essai Private Complete de 14 jours ; Enterprise sur devis
- Périmètre
- Web, mobile natif et hybride, API ; desktop Windows sur offres payantes
- À vérifier avant d’acheter
- L’offre gratuite rend publics tous les tests et résultats
 Testsigma
- Idéal pour
- Équipes QA qui réutilisent des parcours en langage courant sur plusieurs apps
- Tarifs publiés
- Pro et Enterprise sur devis personnalisé
- Périmètre
- Web, mobile, API et Salesforce ; sélecteur de tarifs propre à chaque produit
- À vérifier avant d’acheter
- Disponibilité des agents et plateformes selon l’offre
QA Wolf
QA Wolf : des tests portables, payés à l’exécution
La plateforme cartographie votre application, crée, exécute, diagnostique et maintient les tests, avec vidéos et traces jointes aux rapports de bug. Les tests s’exportent en Playwright ou Appium, vous pouvez apporter votre suite Playwright, et la page tarifs documente un accès MCP pour Codex, Claude Code et Cursor.
La facturation se fait par tranches de cinq minutes, et jusqu’à trois tentatives comptent pour une seule exécution, mesurée sur la plus longue. L’IA et les sièges sont illimités. JumpStart rédige les tests puis vous les confie ; Coverage-as-a-Service, qui les exécute et les maintient aussi, fait l’objet d’un devis.
mabl
mabl : une plateforme unique pour une équipe QA établie
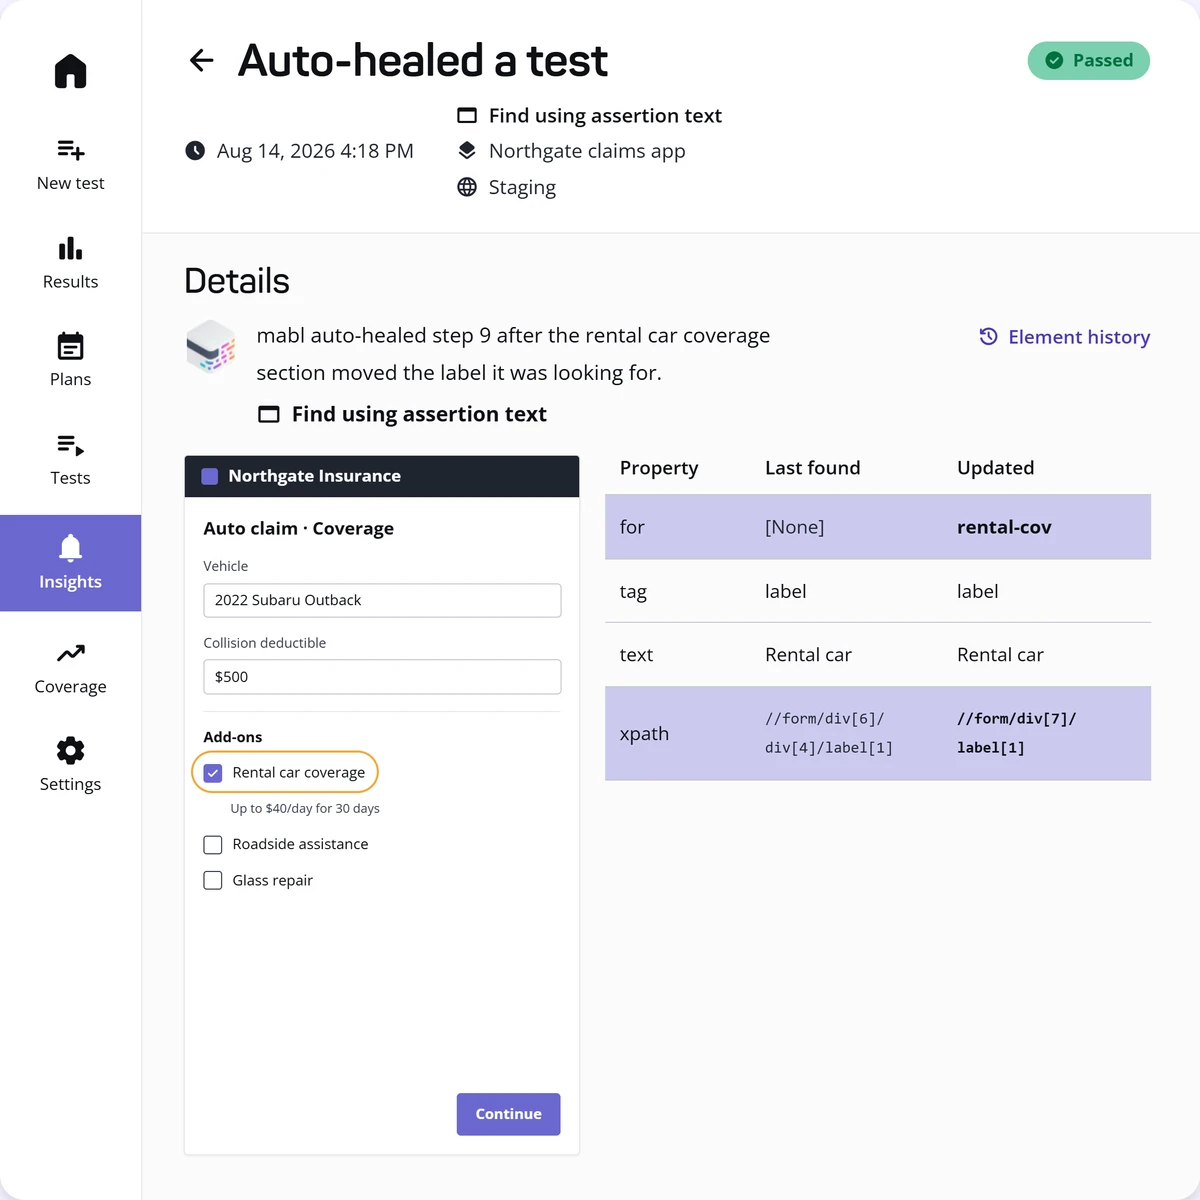
mabl organise le travail en quatre temps, construire, valider, analyser et livrer, avec diagnostics par captures d’écran, auto-réparation avancée, assertions visuelles et tests pilotés par les données. La page tarifs cite les intégrations CI, Jira, Slack, Teams et CLI, utiles pour garder les preuves dans les outils existants.
Les crédits cloud démarrent à 500 par mois ; les exécutions locales et CI sont illimitées, mais un parallélisme cloud illimité ne signifie pas un usage cloud illimité. L’illimité concerne les licences Participant, pas tous les types. Le mobile natif figure parmi les options : faites préciser les plateformes dans le devis.
testRigor
testRigor : des tests en langage courant pour les testeurs manuels
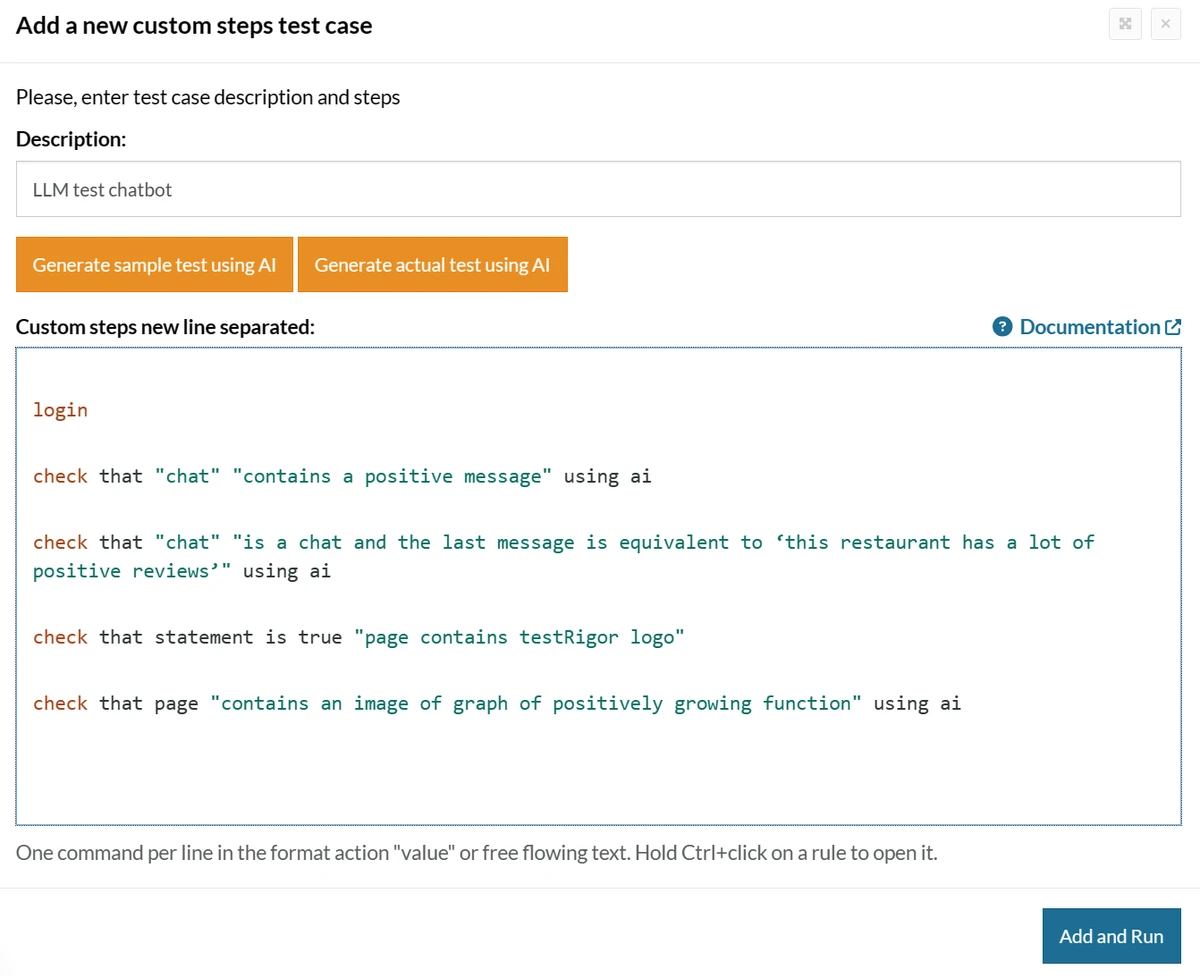
Les tests s’écrivent sous forme de commandes en anglais courant, et les étapes générées peuvent être relues et ajustées par votre équipe. La couverture inclut le web multinavigateur, le mobile natif et hybride, l’API, l’e-mail, le SMS et la 2FA ; la page d’accueil documente aussi MCP et Skills pour Claude Code.
Nous n’avons trouvé aucun prix publié pour l’offre privée : demandez un devis précisant la capacité en parallèle. Une couverture d’appareils plus large passe par BrowserStack ou LambdaTest, pas toujours inclus gratuitement. Vérifiez la couverture des commandes, les données de test, la confidentialité et le format d’export.
Testsigma
Testsigma : des parcours gouvernés sur plusieurs applications
L’offre Pro affiche minutes automatisées et applications illimitées, exécution en parallèle, auto-réparation et intégrations. Enterprise mentionne SSO, cloud privé ou sur site et tests d’accessibilité. Le sélecteur de tarifs dépend du produit : ne supposez ni parallélisme illimité ni appareils réels à tous les niveaux.
La page d’accueil met en avant des agents IA qui génèrent, exécutent, réparent et diagnostiquent les tests web, mobile, API et Salesforce, alors que la page tarifs indique encore Autonomous Testing comme à venir. Demandez une démonstration des agents réellement inclus dans votre offre.
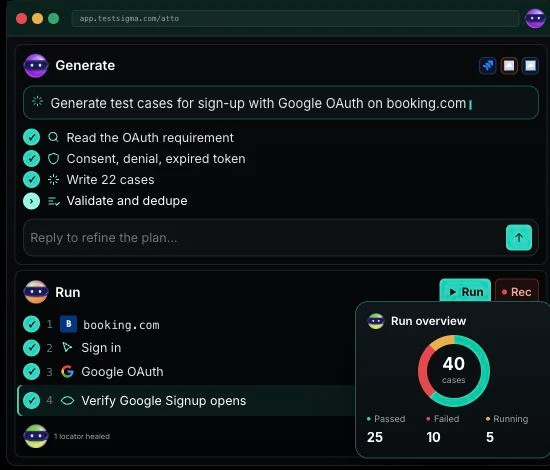
Choisir selon qui possédera les tests
Un test de bout en bout (E2E) suit un parcours utilisateur complet, la CI lance des contrôles automatiques après chaque modification, et l’auto-réparation doit adapter un sélecteur, jamais une règle métier.
- Les développeurs qui veulent du code portable privilégieront des tests Playwright ou Appium exportables, versionnés dans le dépôt et exécutés dans la même chaîne CI que le produit.
- Les testeurs manuels avancent souvent plus vite avec des étapes en langage courant qu’ils peuvent lire, relire et corriger sans demander à un développeur de traduire chaque changement.
- Un service géré apporte de la capacité quand personne n’a le temps d’écrire les tests, mais un responsable métier doit toujours définir les critères d’acceptation avec les développeurs et valider chaque mise en production.
Construire un budget d’exécutions comparable
Faites chiffrer exactement la même charge par chaque éditeur avant de comparer les devis.
- Exemple : 20 tests web critiques, lancés deux fois par jour sur 22 jours ouvrés, font 880 exécutions par mois. Au tarif web de QA Wolf, avec des exécutions de moins de cinq minutes, cela donne 880 USD hors taxes et hors remise de volume.
- Sur trois moteurs de navigateur, la même suite passe à 2 640 exécutions, soit 2 640 USD avec les mêmes hypothèses. Les relances manuelles ajoutent des cycles, tandis que les tentatives incluses ne sont pas refacturées.
- Envoyez cette charge aux autres éditeurs et exigez que chaque devis précise plateformes, conservation des résultats, parallélisme, personnes impliquées et temps de débogage restant à votre charge. Un prix à l’exécution n’est jamais le coût d’une suite complète.
Mener un pilote sur 10 parcours
Comparez deux plateformes présélectionnées sur les mêmes parcours et critères d’acceptation.
- Choisissez dix parcours réels : inscription, connexion, mot de passe oublié, recherche, formulaire, paiement, remboursement ou résiliation, droits d’accès, envoi de fichier et e-mail. Utilisez un environnement de test, des comptes fictifs et le mode test du paiement.
- Rédigez des assertions métier, par exemple un coupon expiré doit être refusé et un utilisateur non autorisé ne voit pas un autre compte. Introduisez ensuite un bug connu et vérifiez que le test échoue au lieu de le contourner.
- Modifiez un libellé anodin et relisez le journal d’auto-réparation, relancez 20 fois sans changement pour compter les fausses alertes, et notez temps de tri, coût et latence. Gardez une validation manuelle des mises en production.
La place de ChatGPT, Claude et des agents de code
Assistants généralistes et plateformes de test n’ont pas le même rôle.
- ChatGPT et Claude aident à préparer les critères d’acceptation et les cas limites. Codex et Claude Code accompagnent le travail sur le code de test. Vous pouvez conserver votre framework et votre CI, ou choisir une plateforme spécialisée pour centraliser exécution, diagnostic et maintenance.
- QA Wolf documente officiellement un accès MCP, et testRigor documente officiellement MCP et Skills pour Claude Code. Ce sont des points de connexion, pas la preuve qu’un assistant produit de meilleurs tests.
- L’automatisation libère du temps pour la recherche client, le jugement produit, les tests exploratoires et les décisions métier. Elle ne rend pas la QA sans effort et ne remplace pas ceux qui définissent la qualité.
FAQ
Quel est le meilleur outil IA pour tester un logiciel ?
Tout dépend de qui possède les tests. QA Wolf convient aux développeurs voulant du code portable, testRigor et Testsigma à la rédaction en langage courant, mabl aux équipes cherchant une plateforme large.
L’IA va-t-elle remplacer les testeurs QA ?
Rien de ce que nous avons vérifié ne l’indique. Ces outils automatisent rédaction, exécution et maintenance, mais des personnes définissent l’acceptation, explorent le produit, évaluent les risques et valident les livraisons.
Peut-on utiliser une offre gratuite pour des tests privés ?
L’offre gratuite de testRigor rend publics tous les tests et résultats : elle ne convient pas aux parcours métier privés. Utilisez l’essai Private Complete ou une offre sur devis.
Combien coûte réellement un outil de test IA ?
Multipliez tests, exécutions quotidiennes, jours ouvrés et plateformes, puis ajoutez relances, personnes et temps de débogage. Demandez à chaque éditeur de chiffrer cette même charge plutôt que comparer des prix d’appel.
L’auto-réparation peut-elle masquer de vrais bugs ?
Une réparation peut masquer un défaut si elle change le résultat attendu. Faites valider les assertions métier, introduisez un échec connu pendant le pilote et examinez l’historique des corrections.
Codex ou Claude Code remplacent-ils ces plateformes ?
Pas nécessairement. Une équipe peut conserver son framework et sa CI avec l’aide d’agents de code. Comparez cet effort d’ingénierie avec l’infrastructure d’exécution, les rapports et la maintenance d’une plateforme spécialisée.
Le test mobile, est-ce la même chose que le web mobile ?
Non. Le web mobile tourne dans le navigateur du téléphone, le mobile natif teste une application installée. Vérifiez que le natif figure dans le devis, certains éditeurs le proposant en option.
Comment démarrer un pilote ?
Choisissez dix parcours critiques dans un environnement de test avec des comptes fictifs, écrivez des assertions métier, introduisez un bug connu, mesurez les fausses alertes et gardez une validation manuelle.
Sources · 19/10/2026
Sources : pages officielles de QA Wolf, mabl, testRigor et Testsigma, et notes G2, consultées le 19 octobre 2026. Offres et prix peuvent évoluer.
Guides associés
D’autres comparatifs pour les équipes qui choisissent des outils IA pour leur produit.
 Meilleurs outils d’automatisation no-code IA en 2026 : Make vs Zapier vs n8n vs ActivepiecesLire le guide →
 Meilleurs agents IA en 2026 : OpenClaw vs Claude Code vs Lindy vs Relevance AILire le guide →
 Meilleurs outils de productivité IA en 2026 : ClickUp vs Notion AI vs Motion vs Reclaim.aiLire le guide →
Protégez aussi les messageries utilisées par vos workflows : comparez les outils IA de sécurité email pour PME, leurs licences et la gestion des faux positifs.
Trouvez le meilleur outil IA
215 outils répertoriés avec leurs fonctionnalités et tarifs. Trouvez celui qui correspond à vos besoins.