Plataformas de teste com IA prometem escrever, executar e corrigir testes de ponta a ponta, mas a escolha certa depende de quem cuidará desses testes depois do lançamento. Este guia compara quatro opções para equipes SaaS e de produto, com páginas dos fornecedores verificadas em 19 de outubro de 2026, e propõe orçamento e piloto.
Resumo rápido
Quatro plataformas de teste com IA comparadas
 QA Wolf
- Ideal para
- Engenheiros que querem testes portáveis, com ajuda humana opcional
- Preços publicados
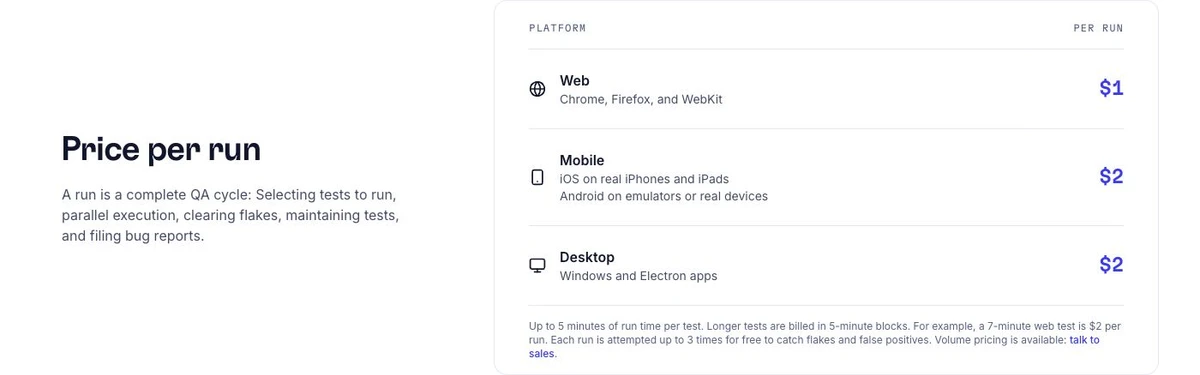
- US$ 1 por execução de teste web; US$ 2 em mobile ou desktop
- Escopo
- Web no Chrome, Firefox e WebKit, além de mobile e desktop
- Verificar antes de comprar
- O custo cresce com execuções, duração e plataformas; defina um teto
 mabl
- Ideal para
- Equipes de QA que querem web, API e controles de qualidade em um só lugar
- Preços publicados
- Sob orçamento; teste gratuito de 14 dias
- Escopo
- Web, API, acessibilidade e desempenho; mobile nativo listado como add-on
- Verificar antes de comprar
- Custo de créditos e extras de mobile exigem orçamento por escrito
 testRigor
- Ideal para
- Equipes de QA manual que escrevem passos legíveis
- Preços publicados
- Plano gratuito público; teste Private Complete de 14 dias; Enterprise sob orçamento
- Escopo
- Web, mobile nativo e híbrido, API; desktop Windows nos planos pagos
- Verificar antes de comprar
- O plano gratuito torna públicos todos os testes e resultados
 Testsigma
- Ideal para
- Equipes de QA que reutilizam fluxos em linguagem simples em vários apps
- Preços publicados
- Pro e Enterprise sob orçamento personalizado
- Escopo
- Web, mobile, API e Salesforce; seletor de preços específico por produto
- Verificar antes de comprar
- Disponibilidade dos agentes e plataformas por plano
QA Wolf
QA Wolf: testes portáveis, pagos por execução
A plataforma mapeia seu app, cria, executa, diagnostica e mantém testes, anexando vídeos e traces aos relatórios de bug. Os testes podem ser exportados em Playwright ou Appium, você pode trazer sua própria suíte Playwright e a página de preços documenta acesso MCP para Codex, Claude Code e Cursor.
A cobrança é feita em blocos de cinco minutos, e até três tentativas contam como uma única execução, medida pela mais longa. Uso de IA e assentos são ilimitados. No JumpStart, a equipe escreve os testes e depois os entrega; o Coverage-as-a-Service, que também executa e mantém, é orçado à parte.
mabl
mabl: uma plataforma para uma prática de QA madura
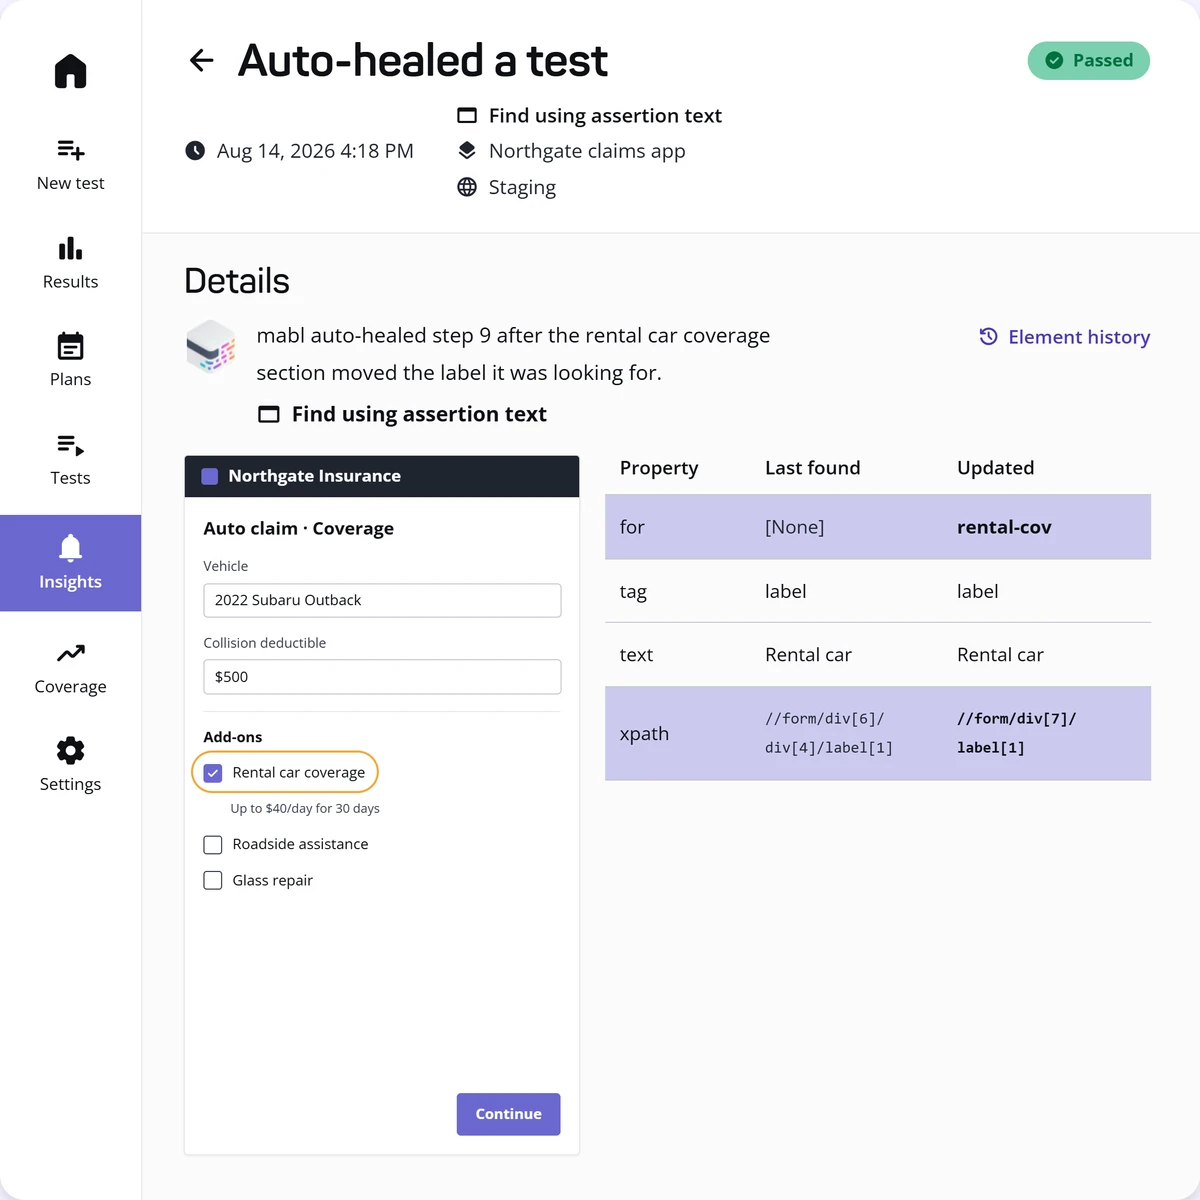
O mabl organiza o trabalho em criar, validar, investigar e liberar, com diagnóstico por capturas de tela, autocorreção avançada, asserções visuais e testes orientados a dados. A página de preços cita integrações com CI, Jira, Slack, Teams e CLI, o que mantém as evidências nas ferramentas já usadas.
Os créditos de nuvem começam em 500 por mês; execuções locais e em CI são ilimitadas, mas concorrência ilimitada na nuvem não significa uso ilimitado da nuvem. O ilimitado vale para licenças Participant, não para todos os tipos. O mobile nativo aparece entre os add-ons, então confirme plataformas no orçamento.
testRigor
testRigor: testes em inglês simples para testadores manuais
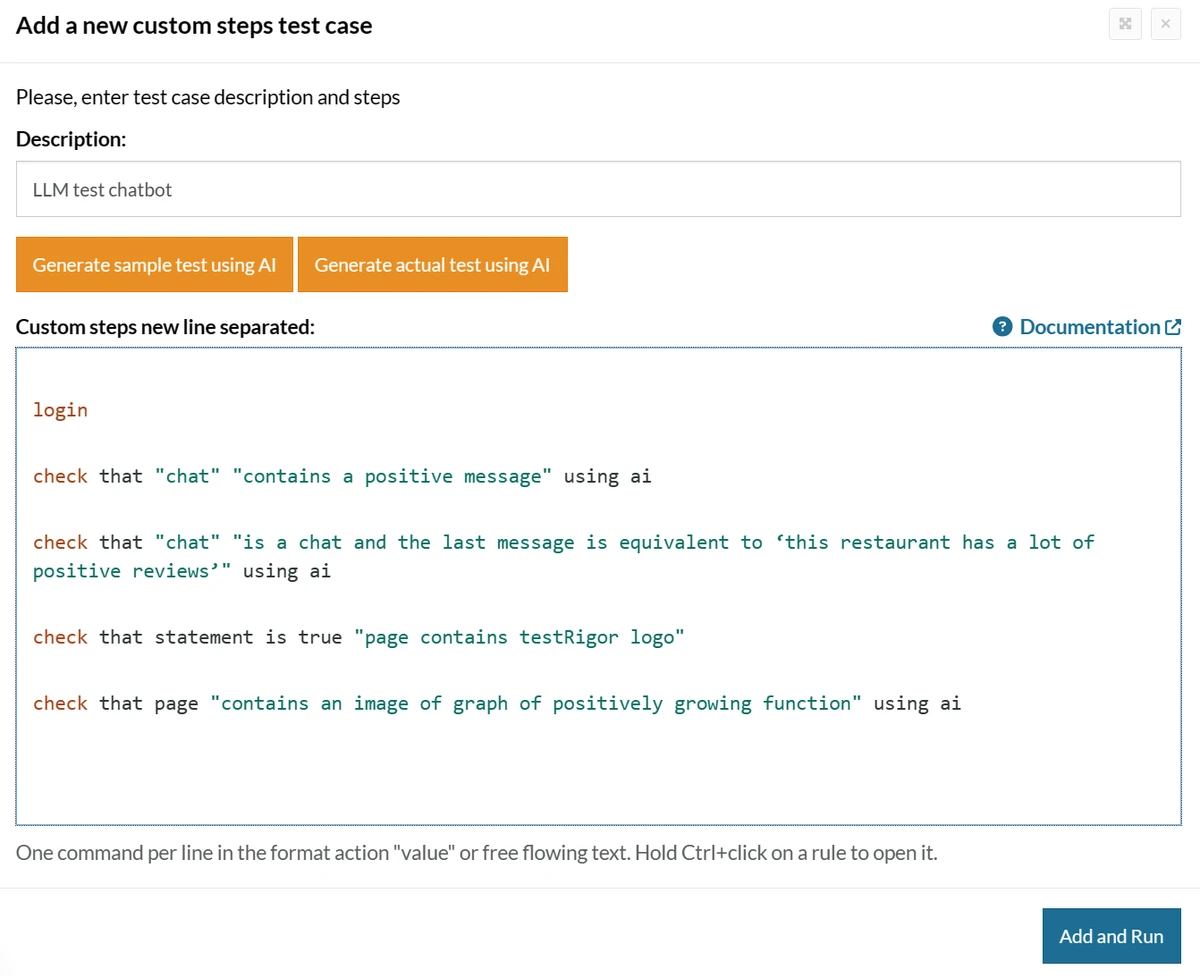
Os testes são escritos como comandos em inglês simples, e sua equipe pode revisar e refinar os passos gerados. A cobertura inclui web em vários navegadores, mobile nativo e híbrido, API, e-mail, SMS e 2FA; a página inicial também documenta MCP e Skills para geração no Claude Code.
Não encontramos preço publicado para o plano privado, então peça um orçamento que informe a capacidade em paralelo. Cobertura mais ampla de dispositivos passa por BrowserStack ou LambdaTest, nem sempre incluídos no gratuito. Verifique cobertura de comandos, dados de teste, privacidade e formato de exportação.
Testsigma
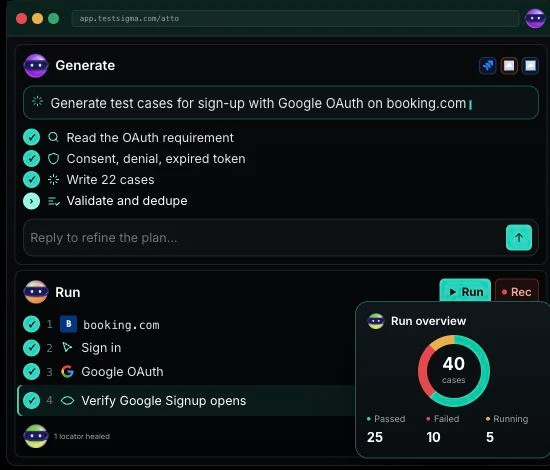
Testsigma: fluxos governados em vários aplicativos
O Pro lista minutos automatizados e apps ilimitados, execução paralela, autocorreção e integrações. O Enterprise menciona SSO, nuvem privada ou on-premises e testes de acessibilidade. O seletor de preços depende do produto, então não presuma concorrência ilimitada nem dispositivos reais em todos os planos.
A página inicial anuncia agentes de IA que geram, executam, corrigem e diagnosticam testes para web, mobile, API e Salesforce, enquanto a página de preços ainda marca o Autonomous Testing como em breve. Peça uma demonstração dos agentes que seu plano realmente inclui.
Escolha por quem será dono dos testes
Um teste de ponta a ponta (E2E) segue uma jornada completa do usuário, a CI dispara verificações automáticas após cada mudança e a autocorreção deve ajustar um localizador, nunca uma regra de negócio.
- Desenvolvedores que querem código portável devem preferir testes Playwright ou Appium exportáveis, guardados no repositório e executados no mesmo pipeline de CI do produto.
- Testadores manuais costumam avançar mais rápido com passos em linguagem simples que conseguem ler, revisar e corrigir sem pedir a um engenheiro que traduza cada mudança.
- Um serviço gerenciado acrescenta capacidade quando ninguém tem tempo de escrever testes, mas uma pessoa responsável pelo negócio deve definir os critérios de aceite com os desenvolvedores e aprovar cada release.
Monte um orçamento de execuções comparável
Peça a cada fornecedor que precifique exatamente a mesma carga antes de comparar orçamentos.
- Exemplo: 20 testes web críticos, rodados duas vezes por dia em 22 dias úteis, somam 880 execuções por mês. Na tarifa web do QA Wolf, com execuções abaixo de cinco minutos, isso dá US$ 880 antes de impostos ou preço por volume.
- Em três motores de navegador, a mesma suíte vira 2.640 execuções, ou US$ 2.640 nas mesmas premissas. Reexecuções manuais são ciclos adicionais, enquanto as novas tentativas incluídas não são cobradas de novo.
- Envie essa carga aos demais fornecedores e exija que cada orçamento informe plataformas, retenção de resultados, paralelismo, pessoas envolvidas e o tempo de depuração que continuará com você. Um preço por execução nunca é o custo de uma suíte inteira.
Faça um piloto com 10 jornadas
Compare duas plataformas selecionadas com os mesmos percursos e critérios de aceitação.
- Escolha dez jornadas reais: cadastro, login, esqueci a senha, busca, formulário, checkout, reembolso ou cancelamento, permissões, upload de arquivo e e-mail. Use um ambiente de teste, contas sintéticas e o modo de teste de pagamento.
- Escreva asserções de negócio, por exemplo que um cupom expirado seja recusado e que um usuário sem permissão não veja outra conta. Depois introduza um bug conhecido e confirme que o teste falha em vez de se corrigir em torno dele.
- Altere um rótulo inofensivo e revise o log de autocorreção, repita 20 execuções sem mudanças para contar alertas falsos e registre tempo de triagem, custo e latência. Mantenha a aprovação manual de cada release.
Onde ChatGPT, Claude e agentes de código se encaixam
Assistentes gerais e plataformas de teste têm papéis diferentes.
- ChatGPT e Claude ajudam a preparar critérios de aceitação e casos-limite. Codex e Claude Code apoiam o trabalho no código dos testes. A equipe pode manter seu framework e CI ou escolher uma plataforma especializada para execução, diagnóstico e manutenção.
- O QA Wolf documenta oficialmente acesso MCP, e o testRigor documenta oficialmente MCP e Skills para o Claude Code. São pontos de conexão, não prova de que um assistente gere testes melhores.
- A automação libera tempo para pesquisa com clientes, julgamento de produto, testes exploratórios e decisões de negócio. Ela não torna o QA automático nem substitui quem define o que qualidade significa.
FAQ
Qual é a melhor ferramenta de IA para testar software?
Depende de quem é dono dos testes. QA Wolf atende engenheiros que querem código portável, testRigor e Testsigma atendem passos em linguagem simples, e mabl atende quem busca uma plataforma ampla.
A IA vai substituir os testadores de QA?
Nada do que verificamos sustenta isso. Essas ferramentas automatizam escrita, execução e manutenção, mas pessoas definem o aceite, exploram o produto, avaliam riscos e aprovam cada release.
Posso usar um plano gratuito para testes privados?
O plano gratuito do testRigor torna públicos todos os testes e resultados, por isso não serve para fluxos de negócio privados. Use o teste Private Complete ou um plano sob orçamento.
Quanto custa de verdade uma ferramenta de teste com IA?
Multiplique testes, execuções diárias, dias úteis e plataformas, depois some reexecuções, pessoas e depuração. Peça a cada fornecedor um orçamento para essa mesma carga, em vez de comparar preços de vitrine.
A autocorreção pode esconder bugs reais?
Uma correção pode esconder um defeito se mudar o resultado esperado. Revise as verificações de negócio, introduza uma falha conhecida no piloto e examine o histórico de alterações.
Codex ou Claude Code substituem essas plataformas?
Não necessariamente. Uma equipe pode manter seu framework e CI com ajuda de agentes de código. Compare esse esforço técnico com a infraestrutura de execução, os relatórios e a manutenção de uma plataforma especializada.
Teste mobile é o mesmo que web mobile?
Não. A web mobile roda no navegador do celular, e o mobile nativo testa um app instalado. Confirme se o nativo está no seu orçamento, pois alguns fornecedores o oferecem como add-on.
Como começar um piloto?
Escolha dez jornadas críticas em um ambiente de teste com contas sintéticas, escreva asserções de negócio, introduza um bug conhecido, meça alertas falsos em execuções repetidas e mantenha a aprovação manual.
Fontes · 19/10/2026
Fontes: páginas oficiais de QA Wolf, mabl, testRigor e Testsigma, além das notas no G2, consultadas em 19 de outubro de 2026. Planos e preços podem mudar.
Guias relacionados
Mais comparativos para equipes que escolhem ferramentas de IA para o produto.
 Melhores ferramentas de automação no-code com IA em 2026: Make vs Zapier vs n8n vs ActivepiecesLer o guia →
 Melhores agentes de IA em 2026: OpenClaw vs Claude Code vs Lindy vs Relevance AILer o guia →
 Melhores ferramentas de produtividade com IA em 2026: ClickUp vs Notion AI vs Motion vs Reclaim.aiLer o guia →
Proteja também as caixas de correio dos seus fluxos de trabalho: compare ferramentas de segurança de email com IA para PME, licenças e gestão de falsos positivos.
Encontre a melhor ferramenta de IA
215 ferramentas listadas com funcionalidades e preços. Encontre a que atende às suas necessidades.