KI-Testplattformen versprechen, End-to-End-Tests zu schreiben, auszuführen und zu reparieren. Die richtige Wahl hängt aber davon ab, wer diese Tests nach dem Start verantwortet. Dieser Leitfaden vergleicht vier Optionen für SaaS- und Produktteams anhand der am 19. Oktober 2026 geprüften Herstellerseiten und leitet daraus Budget und Pilotplan ab.
Das Wichtigste in Kürze
Vier KI-Testplattformen im Vergleich
 QA Wolf
- Ideal für
- Entwickler, die portable Tests und optionale menschliche Hilfe wollen
- Veröffentlichte Preise
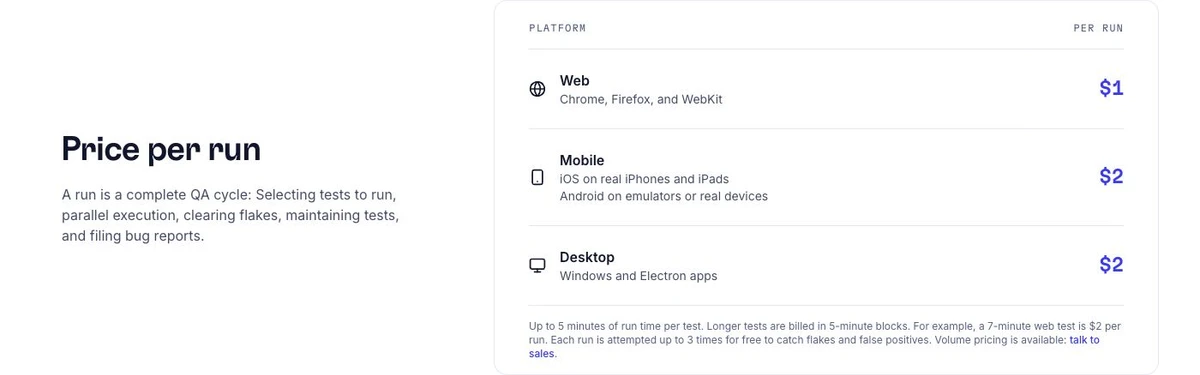
- 1 USD pro Web-Testlauf; 2 USD für Mobile oder Desktop
- Umfang
- Web auf Chrome, Firefox und WebKit, dazu Mobile und Desktop
- Vor dem Kauf prüfen
- Kosten steigen mit Läufen, Dauer und Plattformen; Ausgabenlimit setzen
 mabl
- Ideal für
- QA-Teams, die Web, API und Qualitätschecks an einem Ort wollen
- Veröffentlichte Preise
- Auf Angebot; 14-tägige Testphase
- Umfang
- Web, API, Barrierefreiheit und Performance; natives Mobile als Add-on gelistet
- Vor dem Kauf prüfen
- Credit-Kosten und Mobile-Extras brauchen ein schriftliches Angebot
 testRigor
- Ideal für
- Manuelle QA-Teams, die lesbare Testschritte schreiben
- Veröffentlichte Preise
- Öffentlicher Gratisplan; Private Complete 14 Tage testen; Enterprise auf Angebot
- Umfang
- Web, native und hybride Mobile-Apps, API; Windows-Desktop in Bezahlplänen
- Vor dem Kauf prüfen
- Im Gratisplan sind alle Tests und Ergebnisse öffentlich
 Testsigma
- Ideal für
- QA-Teams, die Abläufe in einfacher Sprache über mehrere Apps wiederverwenden
- Veröffentlichte Preise
- Pro und Enterprise auf individuelles Angebot
- Umfang
- Web, Mobile, API und Salesforce; Preisauswahl je Produkt
- Vor dem Kauf prüfen
- Verfügbarkeit der Agenten und Plattformumfang je Tarif
QA Wolf
QA Wolf: portable Tests, bezahlt pro Lauf
Die Plattform kartiert Ihre Anwendung, erstellt, startet, diagnostiziert und wartet Tests und hängt Videos und Traces an Fehlerberichte. Tests lassen sich als Playwright- oder Appium-Code exportieren, eigene Playwright-Suites können mitgebracht werden, und die Preisseite dokumentiert MCP-Zugang für Codex, Claude Code und Cursor.
Abgerechnet wird in Fünf-Minuten-Blöcken, und bis zu drei Versuche zählen als ein Lauf, gemessen am längsten. KI-Nutzung und Sitzplätze sind unbegrenzt. Bei JumpStart schreibt das Herstellerteam Tests und übergibt sie; Coverage-as-a-Service, das sie auch ausführt und pflegt, wird separat angeboten.
mabl
mabl: eine Plattform für eine etablierte QA-Praxis
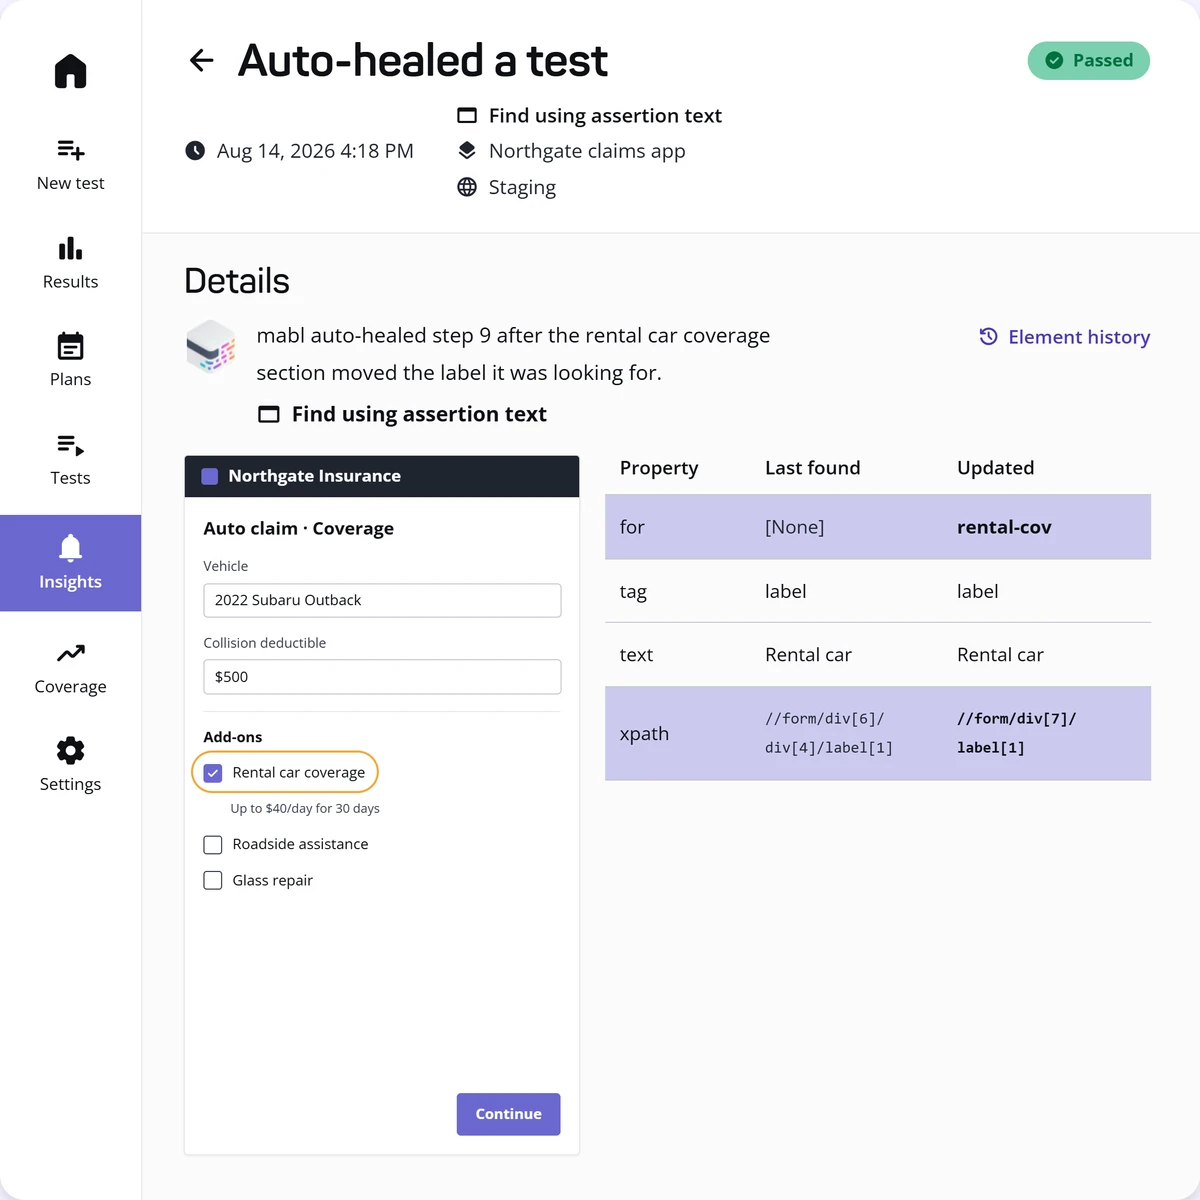
mabl gliedert die Arbeit in Erstellen, Validieren, Untersuchen und Freigeben, mit Screenshot-Diagnose, fortgeschrittenem Auto-Healing, visuellen Assertions und datengetriebenen Tests. Die Preisseite nennt Integrationen für CI, Jira, Slack, Teams und CLI, sodass Belege in den bestehenden Werkzeugen bleiben.
Cloud-Credits beginnen bei 500 pro Monat; lokale und CI-Läufe sind unbegrenzt, doch unbegrenzte Cloud-Parallelität bedeutet keine unbegrenzte Cloud-Nutzung. Unbegrenzt gilt für Participant-Lizenzen, nicht für jeden Lizenztyp. Natives Mobile steht bei den Add-ons, also Plattformen im Angebot festhalten.
testRigor
testRigor: Tests in einfachem Englisch für manuelle Tester
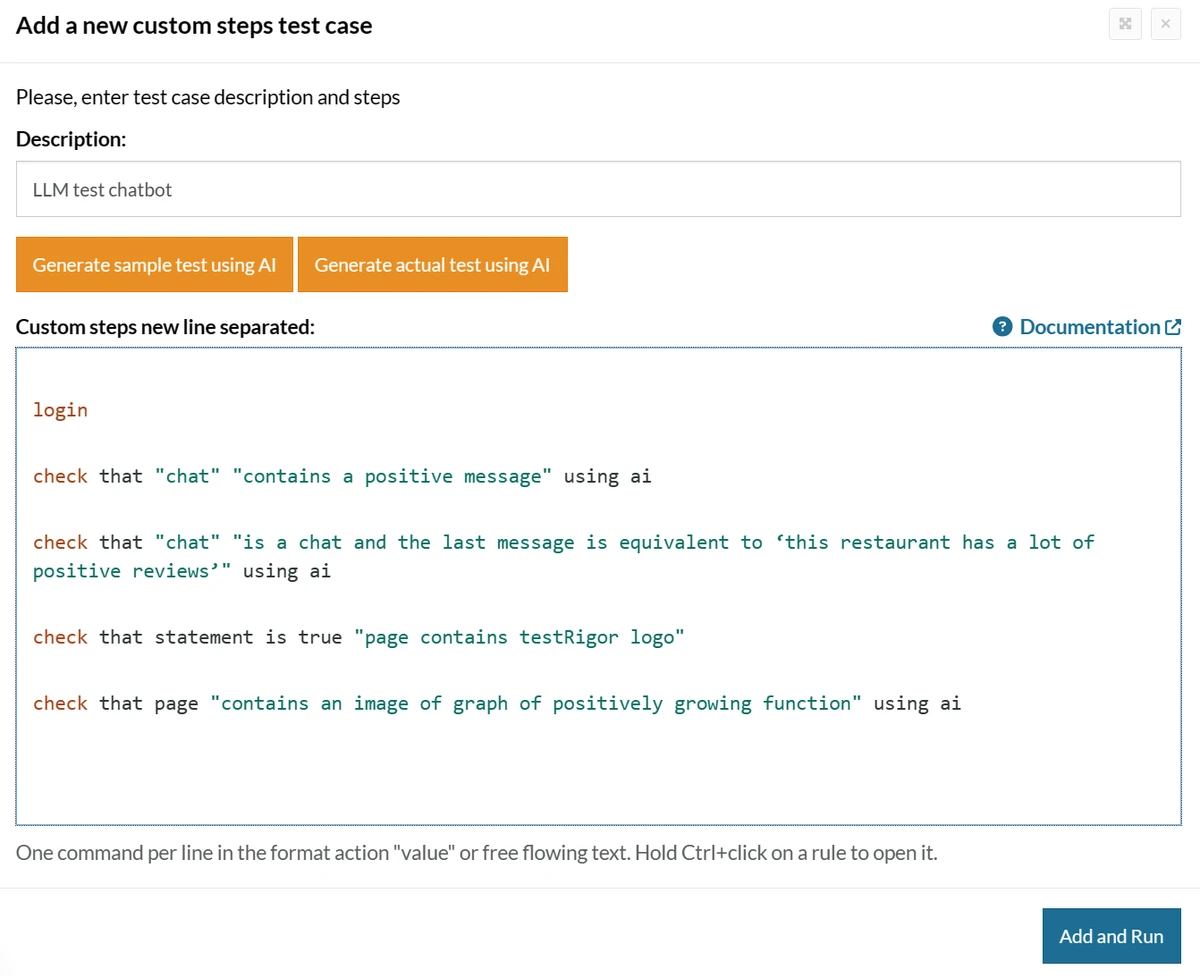
Tests entstehen als Befehle in einfachem Englisch, und generierte Schritte kann Ihr Team prüfen und verfeinern. Abgedeckt sind browserübergreifendes Web, native und hybride Mobile-Apps, API, E-Mail, SMS und 2FA; die Startseite dokumentiert außerdem MCP und Skills für die Generierung in Claude Code.
Für den privaten Plan fanden wir keinen veröffentlichten Preis, also ein Angebot mit klarer Parallelkapazität anfordern. Breitere Geräteabdeckung läuft über BrowserStack oder LambdaTest, nicht alles davon gratis. Prüfen Sie Befehlsabdeckung, Testdaten, Datenschutz und Exportformat.
Testsigma
Testsigma: gesteuerte Abläufe über mehrere Apps
Pro nennt unbegrenzte automatisierte Minuten und Apps, parallele Ausführung, Auto-Healing und Integrationen. Enterprise listet SSO, private oder On-Premises-Cloud und Barrierefreiheitstests. Die Preisauswahl ist produktspezifisch, daher weder unbegrenzte Parallelität noch echte Geräte in jedem Tarif voraussetzen.
Die Startseite bewirbt KI-Agenten, die Tests für Web, Mobile, API und Salesforce erzeugen, ausführen, heilen und diagnostizieren, während die Preisseite Autonomous Testing noch als kommend führt. Lassen Sie sich in einer Demo zeigen, welche Agenten Ihr Tarif tatsächlich enthält.
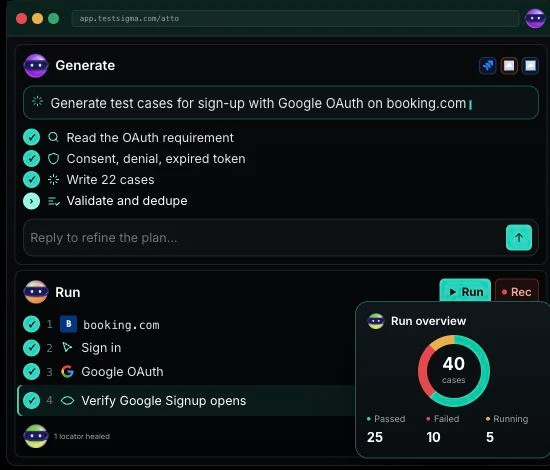
Nach Testverantwortung auswählen
Ein End-to-End-Test (E2E) folgt einem vollständigen Nutzerpfad, CI startet automatische Prüfungen nach jeder Änderung, und Self-Healing sollte einen Locator anpassen, nie eine Geschäftsregel.
- Entwickler, die portablen Code wollen, setzen auf exportierbare Playwright- oder Appium-Tests, die im Repository liegen und in derselben CI-Pipeline wie das Produkt laufen.
- Manuelle Tester kommen meist schneller voran mit Schritten in einfacher Sprache, die sie lesen, prüfen und korrigieren können, ohne jede Änderung von Entwicklern übersetzen zu lassen.
- Ein Managed Service schafft Kapazität, wenn niemand Zeit zum Schreiben hat. Trotzdem sollte eine fachliche Verantwortliche oder ein Verantwortlicher Abnahmekriterien mit den Entwicklern festlegen und jedes Release freigeben.
Ein vergleichbares Laufbudget aufstellen
Lassen Sie jeden Anbieter genau dieselbe Last bepreisen, bevor Sie Angebote vergleichen.
- Beispiel: 20 kritische Web-Tests, zweimal täglich an 22 Arbeitstagen, ergeben 880 Testläufe pro Monat. Zum Web-Tarif von QA Wolf und bei Läufen unter fünf Minuten sind das 880 USD vor Steuern oder Mengenrabatt.
- Auf drei Browser-Engines wird dieselbe Suite zu 2.640 Läufen, also 2.640 USD unter denselben Annahmen. Manuelle Wiederholungen sind zusätzliche Zyklen, enthaltene Wiederholversuche werden nicht erneut berechnet.
- Schicken Sie diese Last an die anderen Anbieter und verlangen Sie Angaben zu Plattformen, Aufbewahrung, Parallelität, beteiligten Personen und Debugging-Zeit, die bei Ihnen bleibt. Ein Preis pro Lauf ist nie der Preis einer ganzen Suite.
Einen Pilot mit 10 Nutzerpfaden fahren
Vergleichen Sie zwei ausgewählte Plattformen anhand derselben Abläufe und Abnahmekriterien.
- Wählen Sie zehn echte Pfade: Registrierung, Login, Passwort vergessen, Suche, Formular, Checkout, Erstattung oder Kündigung, Berechtigungen, Datei-Upload und E-Mail. Nutzen Sie eine Testumgebung, synthetische Konten und den Testmodus der Zahlung.
- Schreiben Sie fachliche Assertions, etwa dass ein abgelaufener Gutschein abgelehnt wird und ein unberechtigter Nutzer kein fremdes Konto sieht. Bauen Sie dann einen bekannten Fehler ein und prüfen Sie, dass der Test fehlschlägt statt ihn wegzuheilen.
- Ändern Sie ein harmloses Label und lesen Sie das Healing-Protokoll, wiederholen Sie unveränderte Läufe 20-mal für Fehlalarme und erfassen Sie Triage-Zeit, Kosten und Latenz. Behalten Sie eine manuelle Release-Freigabe bei.
Wo ChatGPT, Claude und Coding-Agenten passen
Allgemeine Assistenten und Testplattformen erfüllen unterschiedliche Aufgaben.
- ChatGPT und Claude helfen beim Entwurf von Abnahmekriterien und Randfällen. Codex und Claude Code unterstützen die Arbeit am Testcode. Ihr Team kann Framework und CI selbst betreiben oder eine Spezialplattform für Ausführung, Diagnose und Wartung wählen.
- QA Wolf dokumentiert offiziell MCP-Zugang, testRigor offiziell MCP und Skills für Claude Code. Das sind Anbindungen, kein Beweis, dass ein bestimmter Assistent bessere Tests schreibt.
- Automatisierung schafft Zeit für Kundenforschung, Produkturteil, exploratives Testen und geschäftliche Entscheidungen. Sie macht QA nicht mühelos und ersetzt nicht die Menschen, die festlegen, was Qualität bedeutet.
FAQ
Welches KI-Tool ist das beste für Softwaretests?
Das hängt davon ab, wer die Tests verantwortet. QA Wolf passt zu Entwicklern mit Wunsch nach portablem Code, testRigor und Testsigma zu Schritten in einfacher Sprache, mabl zu einer breiten Plattform.
Ersetzt KI QA-Tester?
Nichts, was wir geprüft haben, spricht dafür. Die Tools automatisieren Erstellung, Läufe und Wartung, doch Menschen legen Abnahme fest, erkunden das Produkt, bewerten Risiken und geben Releases frei.
Taugt ein Gratisplan für private Tests?
Der Gratisplan von testRigor macht alle Tests und Ergebnisse öffentlich und eignet sich daher nicht für private Geschäftsabläufe. Nutzen Sie die Private-Complete-Testphase oder einen Angebotstarif.
Was kostet ein KI-Testtool wirklich?
Multiplizieren Sie Tests, tägliche Läufe, Arbeitstage und Plattformen und addieren Sie Wiederholungen, Personal und Debugging-Zeit. Lassen Sie jeden Anbieter genau diese Last anbieten, statt Lockpreise zu vergleichen.
Kann Self-Healing echte Fehler verdecken?
Eine Reparatur kann einen Fehler verdecken, wenn sie das erwartete Ergebnis verändert. Prüfen Sie fachliche Assertions, bauen Sie im Pilot einen bekannten Fehler ein und kontrollieren Sie die Änderungshistorie.
Ersetzen Codex oder Claude Code diese Plattformen?
Nicht unbedingt. Ein Team kann Framework und CI mit Unterstützung durch Coding-Agenten selbst betreiben. Vergleichen Sie diesen Entwicklungsaufwand mit Ausführungsinfrastruktur, Berichten und Wartungsleistungen einer spezialisierten Plattform.
Ist Mobile-Testing dasselbe wie mobiles Web?
Nein. Mobiles Web läuft im Smartphone-Browser, natives Mobile testet eine installierte App. Prüfen Sie, ob natives Mobile im Angebot enthalten ist, denn manche Anbieter führen es als Add-on.
Wie starten wir einen Pilot?
Wählen Sie zehn kritische Pfade in einer Testumgebung mit synthetischen Konten, schreiben Sie fachliche Assertions, bauen Sie einen bekannten Fehler ein, messen Sie Fehlalarme und behalten Sie die manuelle Freigabe.
Quellen · 19/10/2026
Quellen: offizielle Seiten von QA Wolf, mabl, testRigor und Testsigma sowie G2-Bewertungen, geprüft am 19. Oktober 2026. Tarife und Preise können sich ändern.
Verwandte Leitfäden
Weitere Vergleiche für Teams, die KI-Tools für ihre Produktarbeit auswählen.
 Beste KI-No-Code-Automatisierungstools 2026: Make vs. Zapier vs. n8n vs. ActivepiecesLeitfaden lesen →
 Beste KI-Agenten 2026: OpenClaw vs. Claude Code vs. Lindy vs. Relevance AILeitfaden lesen →
 Beste KI-Produktivitäts-Tools 2026: ClickUp vs. Notion AI vs. Motion vs. Reclaim.aiLeitfaden lesen →
Schützen Sie auch die Postfächer Ihrer Workflows: Vergleichen Sie KI-E-Mail-Sicherheit für KMU, Lizenzen und den Umgang mit Fehlalarmen.
Finden Sie das beste KI-Tool
215 Tools mit Funktionen und Preisen aufgeführt. Finden Sie das passende für Ihre Bedürfnisse.